大家好,我是Weekoder!
这是我的第一篇文章,如果有做的不好的地方,请见谅,我会尽力改正。
本文中的图片截取于网络视频,非恶意搬运。
二分法,是一个高效的算法,查找一个数的时间复杂度只需要\(O(\log n)\),大大优化了朴素算法(从头到尾地遍历)\(O(n)\)的线性复杂度。稍后我会对它的对数复杂度做分析。
举个例子,当你要在一个长度为\(2\times 10^9\)(20亿)的数组中里查找一个数时,朴素算法\(O(n)\)的复杂度肯定会超时,更别说去寻找多个数了。但如果使用二分法进行查找,查找一次只需大约运行30次!真是恐怖的差别。
那么,到底该怎么实现二分法,实现二分法又有什么条件呢?这是我们接下来要解决的问题。
二分法,是指在有序序列中通过折半的方式快速锁定目标的位置,在不断的二分下,最终找到答案。别急,我第一次看到的时候也是一头雾水。那么,我们来分析一下这段话。
这个问题很好地引入了二分法的实现。我们来看一段伪代码。
int left = 0, right = n + 1;
while (还没有结束) {
    int mid = (left + right) / 2;
    if (...)
		left = mid;
    else
		right = mid;
}
可以看到,我们先定义了两个指针 left 和 right(其实就是类似于 for 循环中的 i 和 j,不是什么很深奥的东西,不要像我一开始一样被误导了),分别指向数组的第一个元素的前一个位置和最后一个元素的后一个位置,它们之间就是答案所在的范围。在while循环中间,又定义了一个 mid,它指向的是left和right的中间,最好是写作\(mid=(left+right)>>1\)(位运算,等同于除以2)。然后,当触发了某个条件,left会指向mid,否则会让right指向mid。请思考这样做的含义。等等,这不就是相当于把答案的范围折半了吗?于是,我们就顺利地完成了折半的操作。总结一下,就是每次计算 left 和 right 的中间,并在某种判断条件下让 left 或 right 指向 mid,也就是折半。
现在,让我们换一种角度思考。不是去思考left和right之间是什么,而是去思考left和right之前是什么,即1--left和right--n这两个区间。请认真再反复思考这句话的含义。
我们现在来看这样一张图片:left 指向蓝色区域(下标 1--left)从左往右的最后一个元素4,而 right 指向红色区域(下标 right--n(8))从右往左的最后一个元素5。
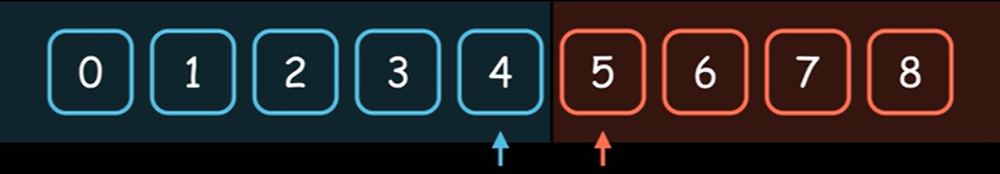
这样就好理解了,蓝色区域 1--left 可以理解为是 left 扩展的区域,而红色区域 right--n 可以理解为是 right 扩展的区域。也就是说,二分查找其实就是在不断扩展 left 和 right,最后根据情况返回 left 或 right。 为什么是根据情况返回 left 或 right 呢?因为在实际情况中,有可能要求返回 left,也有可能要求返回 right,但肯定是不会直接像“请返回 left”这样直接告诉你的。接下来我们逐一来补全伪代码中未完成的部分。
这是实现二分法的条件:数组需要有序。可以是单调不递减(从小到大)或单调不递增(从大到小)。为解决这个疑问,我们来补全伪代码中while循环里的if条件,也就是让 left 或 right 指向 mid 时 是让 left 还是 right 指向 mid 的条件。
我们来看为什么朴素算法的效率低下。从我们之前扩展的角度来看,朴素算法相当于是两个指针在一个个缓慢扩展,直到遇到对方区域才停止。
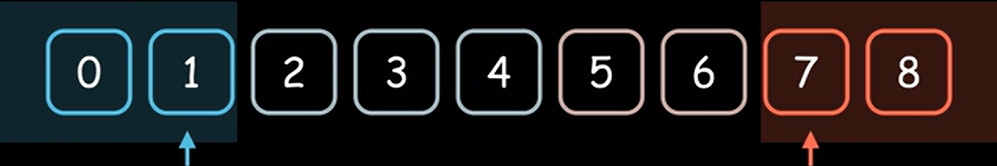
可以看到,这样的效率是很低下的。
那么,二分是怎样对扩展优化的呢?
答案是每次计算中间值 mid,判断 mid 属于哪种颜色,并直接让 left 或 right 指向 mid,于是就一下子扩展了很多。 这里假设 mid 现在指向的区域是蓝色的,那么我们就会让 left 直接指向 mid。 这意味着什么? 既然蓝色区域已经扩展到 mid 了,那么就说明 mid 之前的数也必须是蓝色的,这样这个操作才合法,才是正确的。那我们怎么保证 mid 之前的数是蓝色的呢? 很简单,只要让数组有序就行了,这样就能保证 mid 之前的数全部小于现在 mid 指向的数,也就全部是蓝色的了。 同理,只要数组有序, right
之前的数也全部都大于 right 现在指向的数,这个扩展操作也能成功。
总结一下,数组需要有序是因为这样二分时扩展的优化才能合法,并且我们又解决了一个问题:while循环里的if条件是在判断 mid 是属于什么颜色的。 我们把这个判断称为\(IsBlue\)(属于蓝色区域)。
现在更新伪代码为:
int mid = (left + right) >> 1;
if (IsBlue(mid))
    left = mid;
else
    right = mid;
到这里,我们终于把伪代码补全了。具体要分几次取决于while循环的条件。
我们知道,二分法其实就是不断扩展 left 和 right 的过程,而我们观察上一幅图,当 left 和 right 处于什么关系时,扩展就完成了?答案也呼之欲出了:\(left+1=right\) 。
于是,我们完成伪代码的最后更新:
int left = 0, right = n + 1;
while (left + 1 != right) {
    int mid = (left + right) / 2;
    if (IsBlue(mid))
		left = mid;
    else
		right = mid;
}
return left or right;
至此,二分法的概念和实现就讲得差不多了。
那么,我们也就知道了,因为二分查找其实是在不断折半,所以总时间复杂度刚好是 \(O(\log n)\)。
为什么left的初始值为0,right的初始值为n+1?不能等于1和n吗?
设想一下,如果整个数组都是红色,那么 left 一开始就会指向红色区域,造成错误;同理,如果整个数组都是蓝色,那么 right 一开始就会指向蓝色区域,同样会造成错误,所以将指针初始化为 \(0\) 和 \(n+1\)。
在更新指针时,能写成 \(left=mid+1\) 或者 \(right=mid-1\)吗?
我们来看一个例子:

设想一下,这个时候如果 \(left=mid+1\),会发生什么?没错,left 会指向红色区域,导致错误。同理,如果 mid 指向红色区域的最后一个元素,right 也会指向蓝色区域,导致错误。所以,将 left 和 right 直接指向 mid 更合适。
做一道例题就明白了。
给定一个有序整数数组 \(a[]\) 和一个整数数组 \(x[]\) 以及它们的长度 \(aLen\) 和 \(xLen\)。\((0\le a_i\le 2\times 10^6,0\le x_i\le 10^8,aLen,xLen\le 10^6)\)
现在定义 \(f(i)\) 为第一个符合 \(a_j\ge x_i\) 的 \(j\),如果没有,返回 \(0\)。
试求出 \(f(1,2,3,...xLen-1,xLen)\)。保证有解。
数组又是有序的,又要查找多个数,很容易想到效率高的二分查找。那我们做题时该怎么建模呢?放心,一点也不难。我们只需要把伪代码中的 \(IsBlue\) 条件和到底是要返回 left 还是 right 搞清楚就行了。现在我们来划分红蓝区域。
首先,题目要求我们返回的是第一个符合条件的数,我们来看一下能不能把蓝色区域定义为大于等于 \(x_i\) 的数。显然是不可以的,因为蓝色区域是从左到右的,指向的是最后一个大于等于 \(x_i\) 的元素,所以要把红色区域定义为大于等于 \(x_i\) 的数,蓝色区域就是小于 \(x_i\) 的元素。\(IsBlue\) 的条件就是 \(a[mid]<x_i\),最后返回 right。给出代码如下。
#include <bits/stdc++.h>
using namespace std;
const int N = 1e6 + 5; // 数组大小
int a[N], x[N], aLen, xLen; // a数组,x数组,它们的大小
void bin_search(int x) { // 写成函数方便快捷
    int l = 0, r = aLen + 1; // 指针初始化要在边界外
    while (l + 1 != r) { // 当扩展还未结束
        int mid = (l + r) >> 1; // 计算中间值,>> 位运算,等同于除以2
        if (a[mid] < x) // 当处于蓝色区域
	    	l = mid; // 蓝色区域扩展
        else // 否则就是红色区域
            r = mid; // 红色区域扩展
    }
    if (a[r] == x) cout << r << " "; // 如果查找的答案符合
    else cout << 0 << " "; // 没有找到,输出0
    return ; // 函数最好都要写返回
}
int main() {
    cin >> aLen >> xLen; // 输入数组大小
    for (int i = 1; i <= aLen; i++) cin >> a[i]; // 输入a数组
    for (int i = 1; i <= xLen; i++) cin >> x[i]; // 输入x数组
    for (int i = 1; i <= xLen; i++) // 循环输出f(i)
		bin_search(x[i]); // 二分查找函数
    return 0; // 大功告成!
}
可以输入样例自测。
5 3
2 5 7 9 11
6 2 15
3 1 0
总结一下二分法的总体建模思路,就是确定红蓝区域以及返回 left 还是 right,并套用模板求解。当然,有一些细节也要处理,比如指针的初始值,扩展时防止跑到对面区域等。
怎么样,你是否看懂了二分法的所有过程并理解了呢?其实二分法的思想很简单,但实现的过程中总会遇到一些麻烦。所以我才写了我的第一篇文章,想帮助大家理解二分法并能熟练运用它。希望你喜欢。