译者注: 到底是 AI 会吃掉软件还是软件会吃掉 AI?为了 job security 工程师应该把宝押在哪儿?这篇 2021 年的文章提供的一些视角似乎印证了它现在的流行,有点“运筹于帷幄之中,决胜于数年之后”的意思,颇值得软件架构师和产品经理们内省一番。
2021 版的 《人工智能现状报告》 于上周发布。Kaggle 的 机器学习和数据科学现状调查 也于同一周发布了。这两份报告中有很多值得学习和探讨的内容,其中一些要点引起了我的注意。
“人工智能正越来越多地应用于关键基础设施,如国家电网以及新冠大流行期间的自动化超市仓储计算。然而,人们也在质疑该行业的成熟度是否赶上了其不断增长的部署规模。”
无可否认,以机器学习引擎的应用正渗透至 IT 的每个角落。但这对公司和组织意味着什么?我们如何构建坚如磐石的机器学习工作流?每个公司应该聘请 100 名数据科学家抑或是 100 名 DevOps 工程师吗?
“Transformer 模型已成为 ML 的通用架构。不仅适用于自然语言处理,还适用于语音、计算机视觉甚至蛋白质结构预测。”
老一辈人的血泪教训是: IT 领域 没有万能灵丹。然而,transformer 架构又确实在各式各样的机器学习任务中都非常有效。但我们如何才能跟上机器学习创新的疯狂脚步呢?我们真的需要专家级的技能才能用上这些最先进的模型吗?抑或是否有更短的路径可以在更短的时间内创造商业价值?
好,以下是我的一些想法。
机器学习无处不在,或者至少它试图无处不在。几年前,福布斯写道“软件吞噬了世界,而现在人工智能正在吞噬软件”,但这到底意味着什么?如果这意味着机器学习模型应该取代数千行僵化的遗留代码,那么我完全赞成。去死,邪恶的商业规则,去死!
现在,这是否意味着机器学习实际上将取代软件工程?现在肯定有很多关于 人工智能生成的代码 的幻想,其中一些技术确实很有趣,例如用于 找出 bug 和性能问题 的技术。然而,我们不仅不应该考虑摆脱开发人员,还应该努力为尽可能多的开发人员提供支持,以使机器学习成为另一个无聊的 IT 工作负载 (但 无聊的技术很棒)。换句话说,我们真正需要的是软件吃掉机器学习!
多年来,我一直在虚张声势地宣称: 软件工程已有的长达十年历史的最佳实践同样适用于数据科学和机器学习: 版本控制、可重用性、可测试性、自动化、部署、监控、性能、优化等。我一度感觉自己很孤单,直到谷歌铁骑的出现:
“做你擅长的,以卓越工程师的身份而不是以卓越机器学习专家的身份去做机器学习。” - 《机器学习的规则》,Google
没有必要重新发明轮子。DevOps 运动在 10 多年前就解决了这些问题。现在,数据科学和机器学习社区应该立即采用这些经过验证的工具和流程并作适当调整。这是我们在生产中构建强大、可扩展、可重复的机器学习系统的唯一方法。如果将其称为 MLOps 对事情有帮助,那就这么叫它!关键是其内涵,名字并不重要。
确实是时候停止将概念验证和沙箱 A/B 测试视为显著成就了。它们只是迈向生产的一小块垫脚石,即它是唯一可以验证假设及其对业务的影响的地方。每个数据科学家和机器学习工程师都应该致力于尽可能快、尽可能频繁地将他们的模型投入生产。 能用的生产模型无一例外都比出色的沙箱模型好。
都 2021 年了,IT 基础设施不应再成为阻碍。软件不久前已经吞噬了它,通过云 API、基础设施即代码、Kubeflow 等将其抽象化。是的,即使是自建基础设施也已经被软件吞噬了。
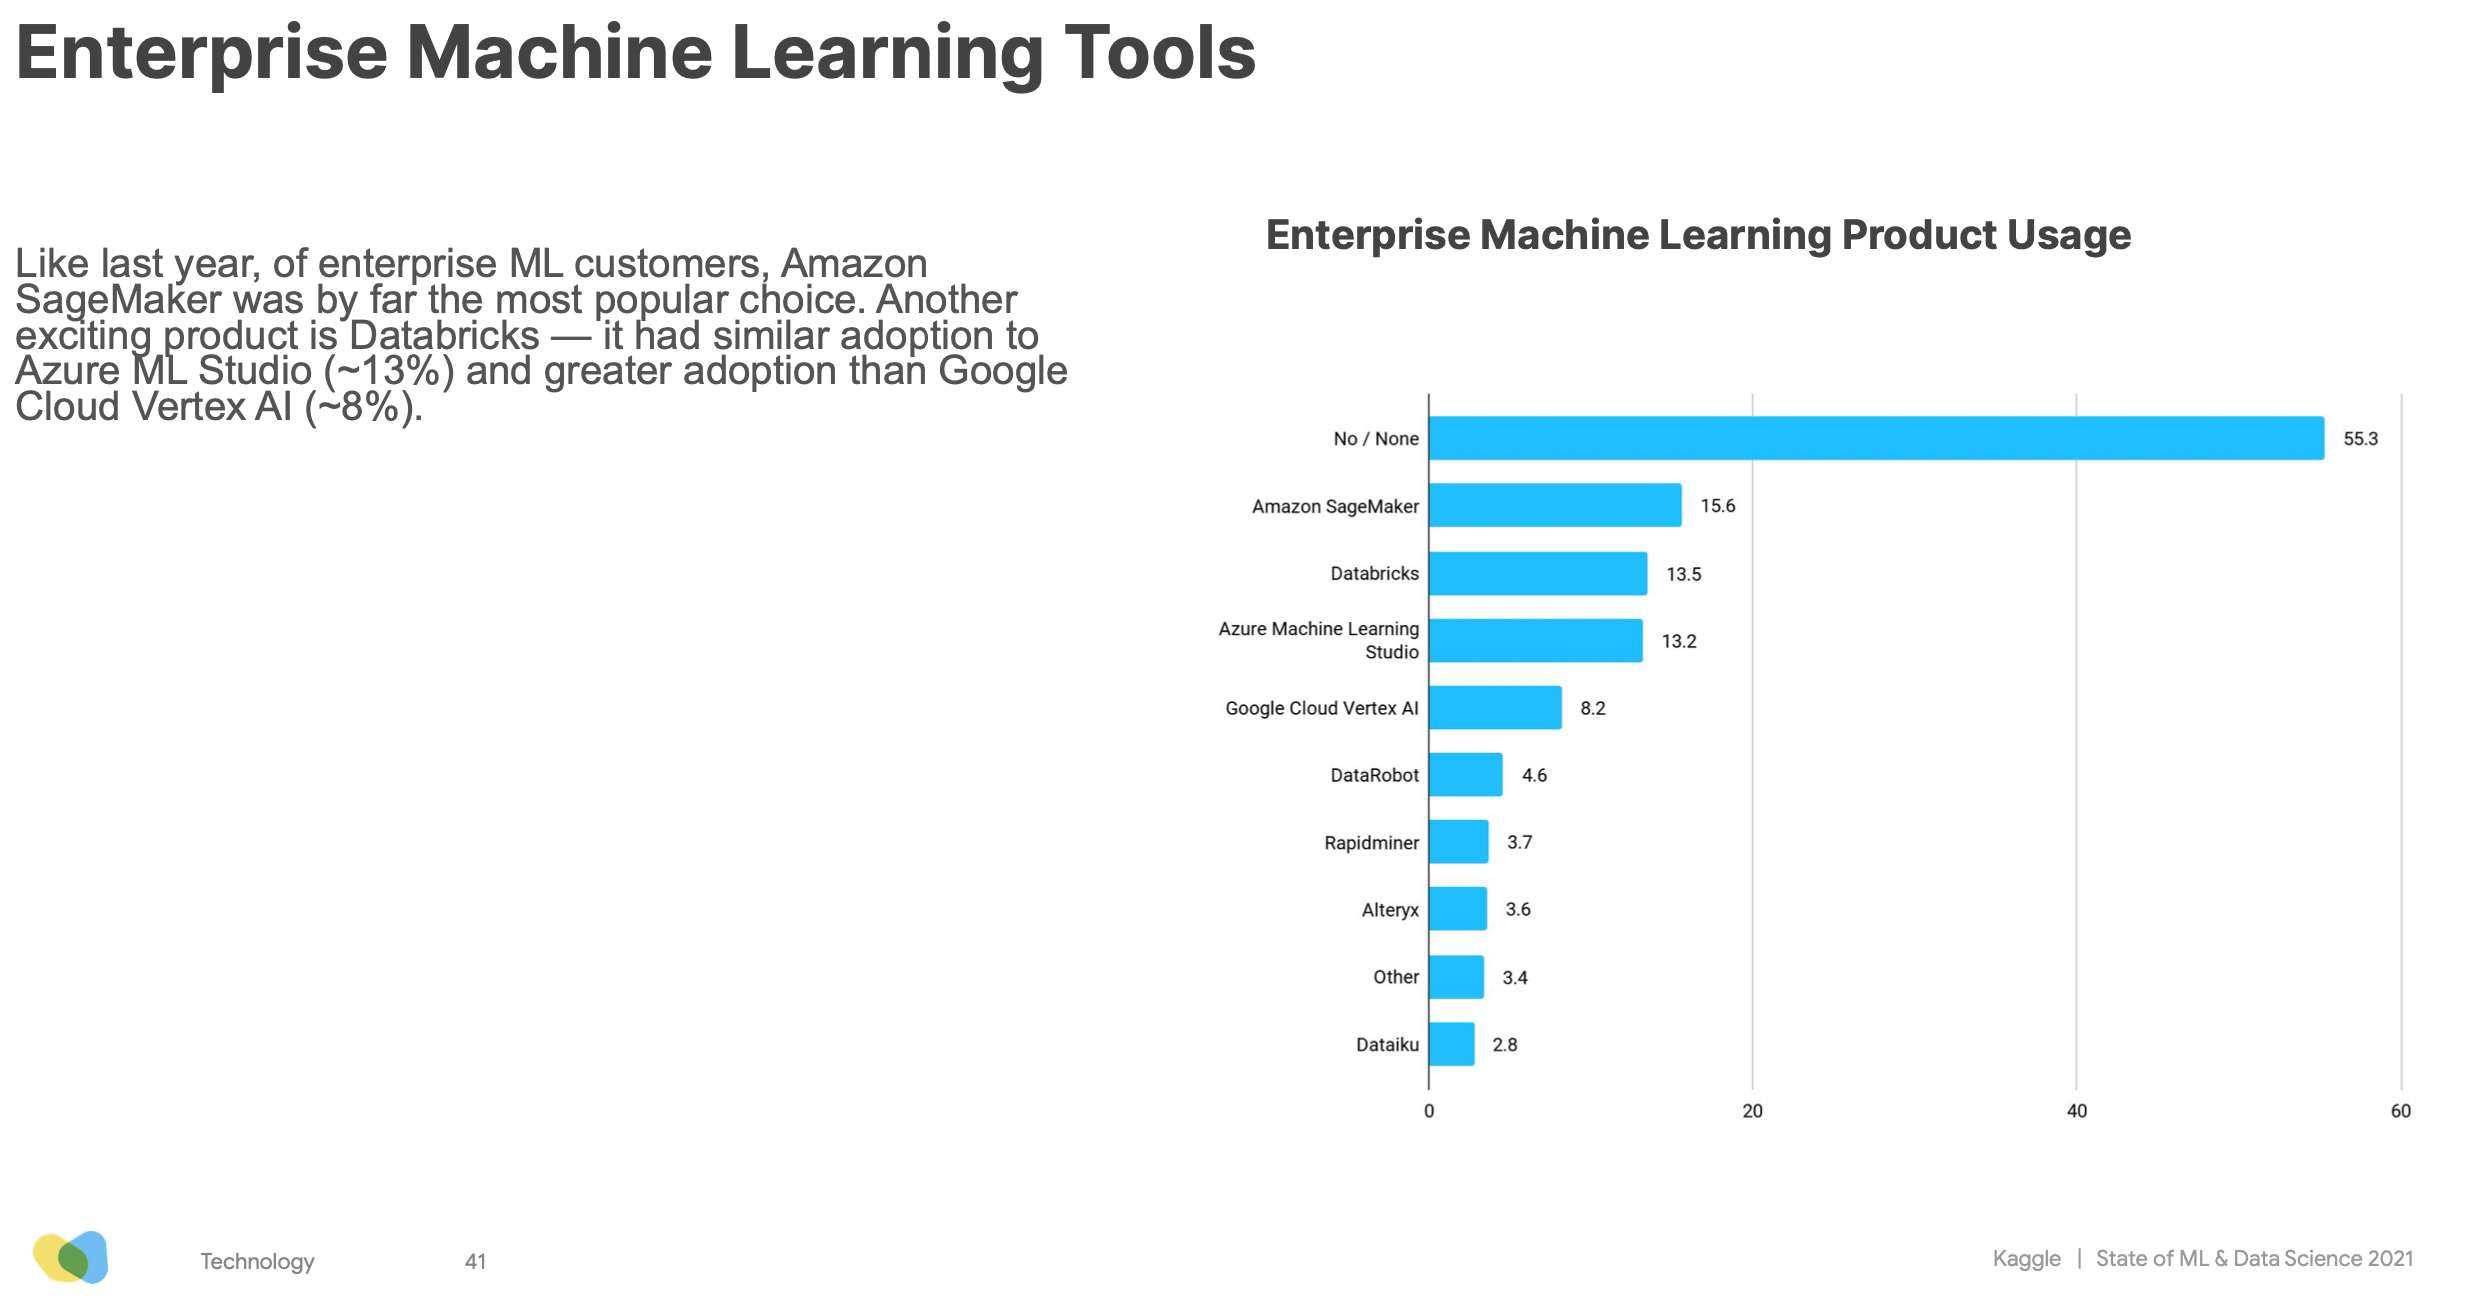
机器学习基础设施也很快就会发生同样的情况。 Kaggle 调查显示,75% 的受访者使用云服务,超过 45% 的受访者使用企业机器学习平台,其中 Amazon SageMaker、Databricks 和 Azure ML Studio 位列前三。
借助 MLOps、软件定义的基础设施和平台,将任意一个伟大的想法从沙箱中拖出来并将其投入生产已变得前所未有地容易。回答最开始的问题,我很确定你需要雇用更多精通 ML 的软件和 DevOps 工程师,而不是更多的数据科学家。但其实在内心深处,你本来就知道这一点,对吗?
现在,我们来谈谈 transformer 模型。
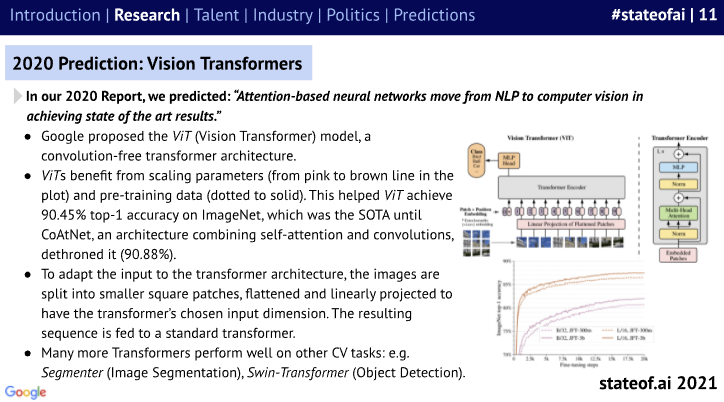
AI 现状报告称: “Transformer 架构已经远远超出了 NLP 的范围,并且正在成为 ML 的通用架构”。例如,最近的模型,如 Google 的 Vision Transformer、无卷积 transformer 架构以及混合了 transformer 和卷积的 CoAtNet 为 ImageNet 上的图像分类设定了新的基准,同时对训练计算资源的需求更低。
Transformer 模型在音频 (如语音识别) 以及点云 (一种用于对自动驾驶场景等 3D 环境进行建模的技术) 方面也表现出色。
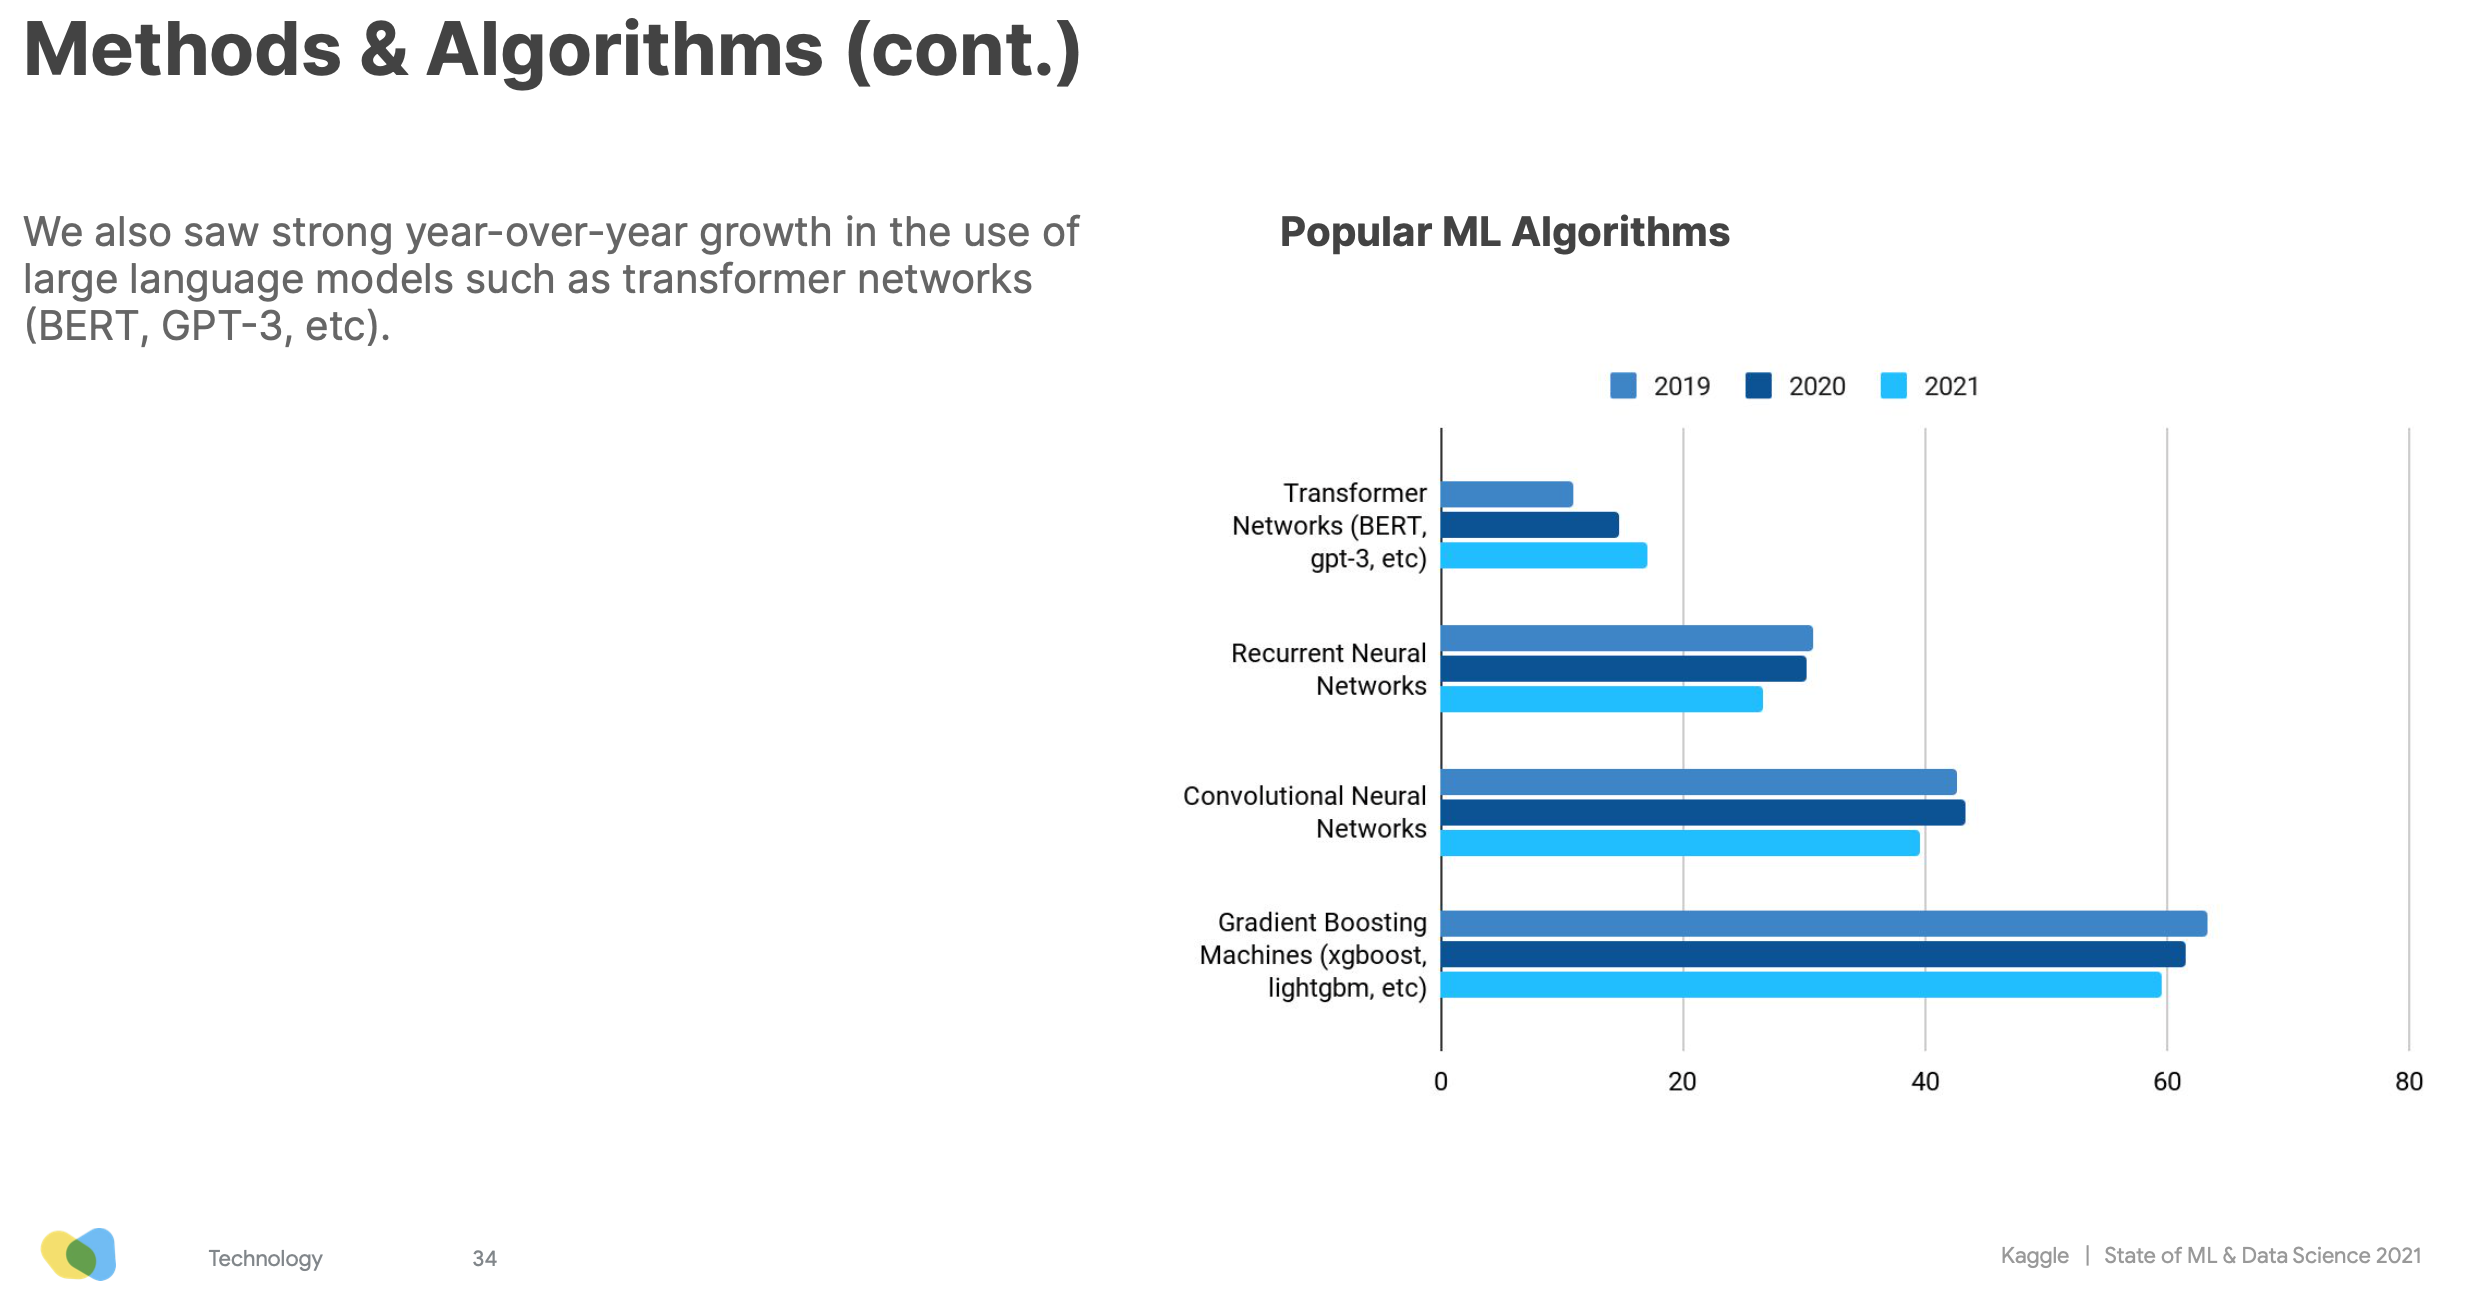
Kaggle 的调查也呼应了 transformer 模型的崛起。它们的使用量逐年增长,而 RNN、CNN 和梯度提升算法则在减少。
除了提高准确性之外,transformer 模型也在持续加强其在迁移学习方面的能力,这样大家就可以节约训练时间和计算成本,更快地实现业务价值。
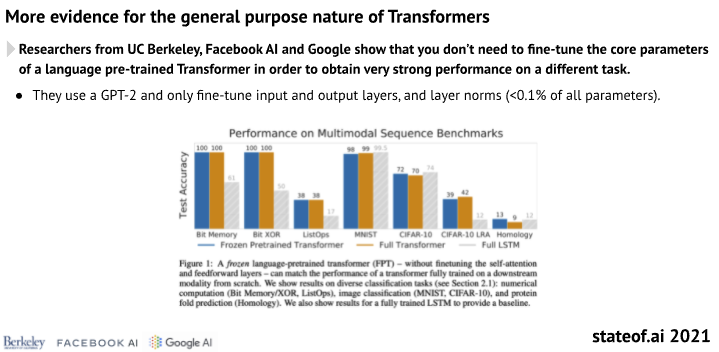
借助 transformer 模型,机器学习世界正逐渐从“ 好!!让我们从头开始构建和训练我们自己的深度学习模型 ”转变为“ 让我们选择一个经过验证的现成模型,用我们自己的数据对其进行微调,然后早点回家吃晚饭。 ”
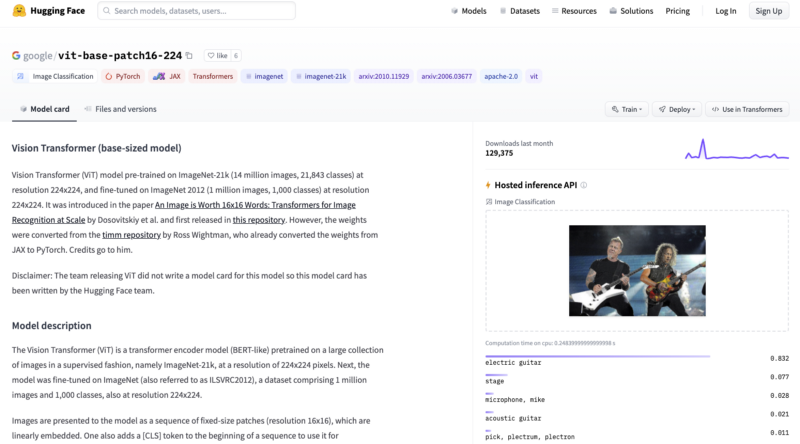
从很多方面来说,这都是一件好事。技术水平在不断进步,几乎没有人能跟上其步伐。还记得我之前提到的 Google Vision Transformer 模型吗?你想现在就测试一下吗?在 Hugging Face 上,这 再简单不过了。
那如果想试试 Big Science 项目 最新的 零样本文本生成模型 呢?
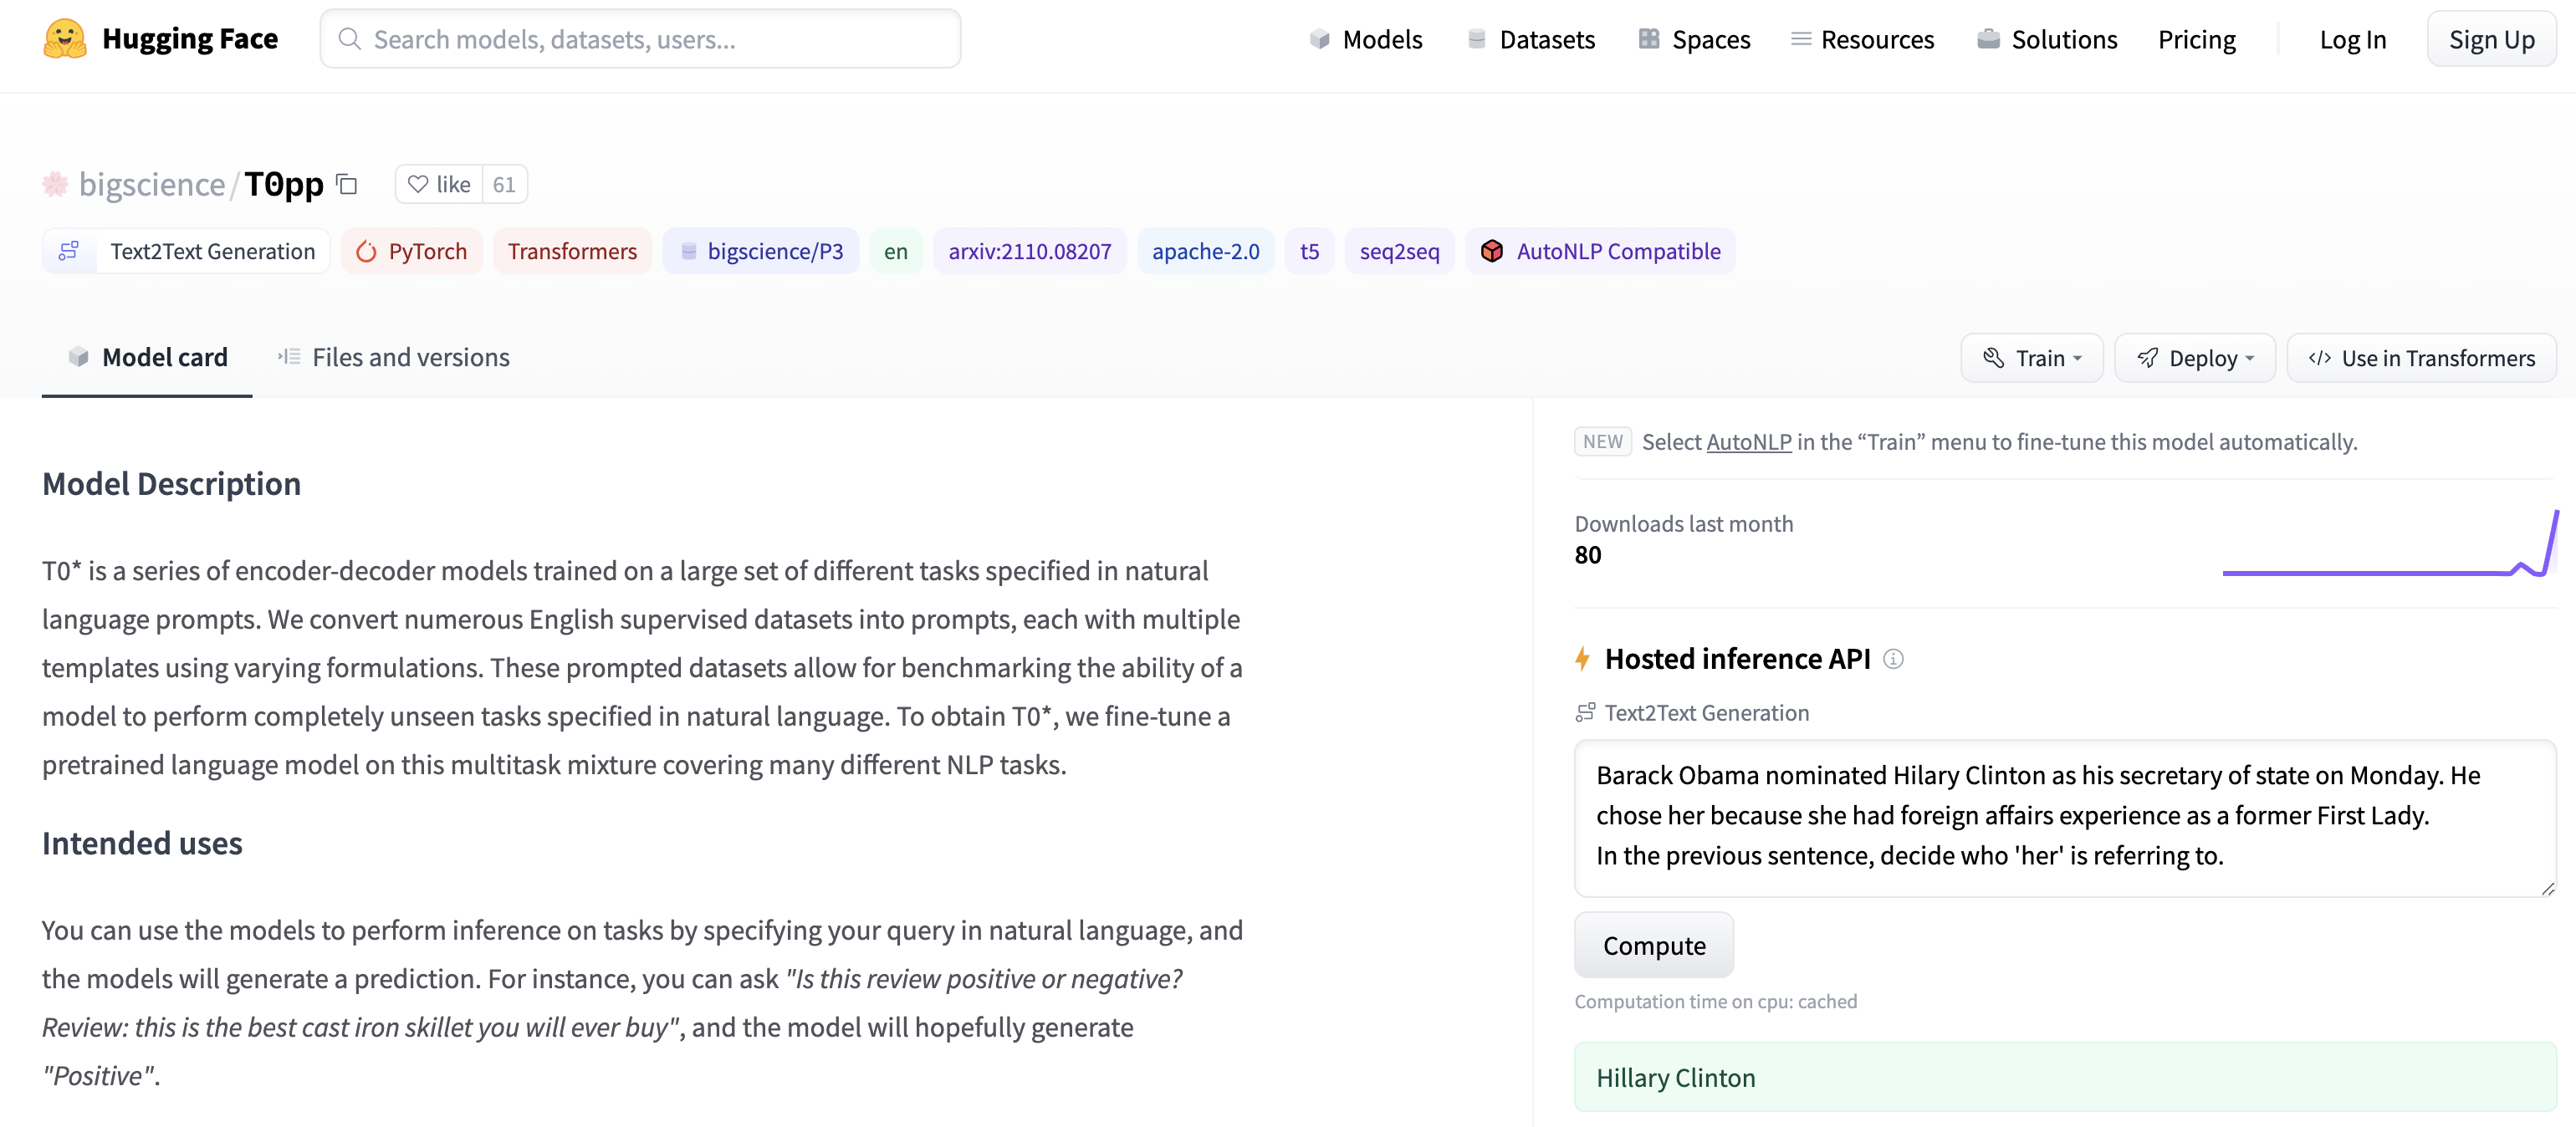
你还可以对另外 16000 多个模型 以及 1600 多个数据集 做同样的事情。进一步地,你还可以用我们提供的其他工具进行 推理、AutoNLP、延迟优化 及 硬件加速。我们甚至还能帮你启动项目,完成 从建模到生产 的全过程。
Hugging Face 的使命是让机器学习对初学者和专家来说都尽可能友好且高效。
我们相信你只要编写尽可能少的代码就能训练、优化和部署模型。
我们相信内置的最佳实践。
我们坚信基础设施应尽可能透明。
我们相信,没有什么比快速高质的生产级模型更好的了。
大家似乎都同意这句话。我们的 Github 有超过 52000 颗星。在 Hugging Face 首次出现在 Kaggle 调查报告中时,其使用率就已超过 10%。
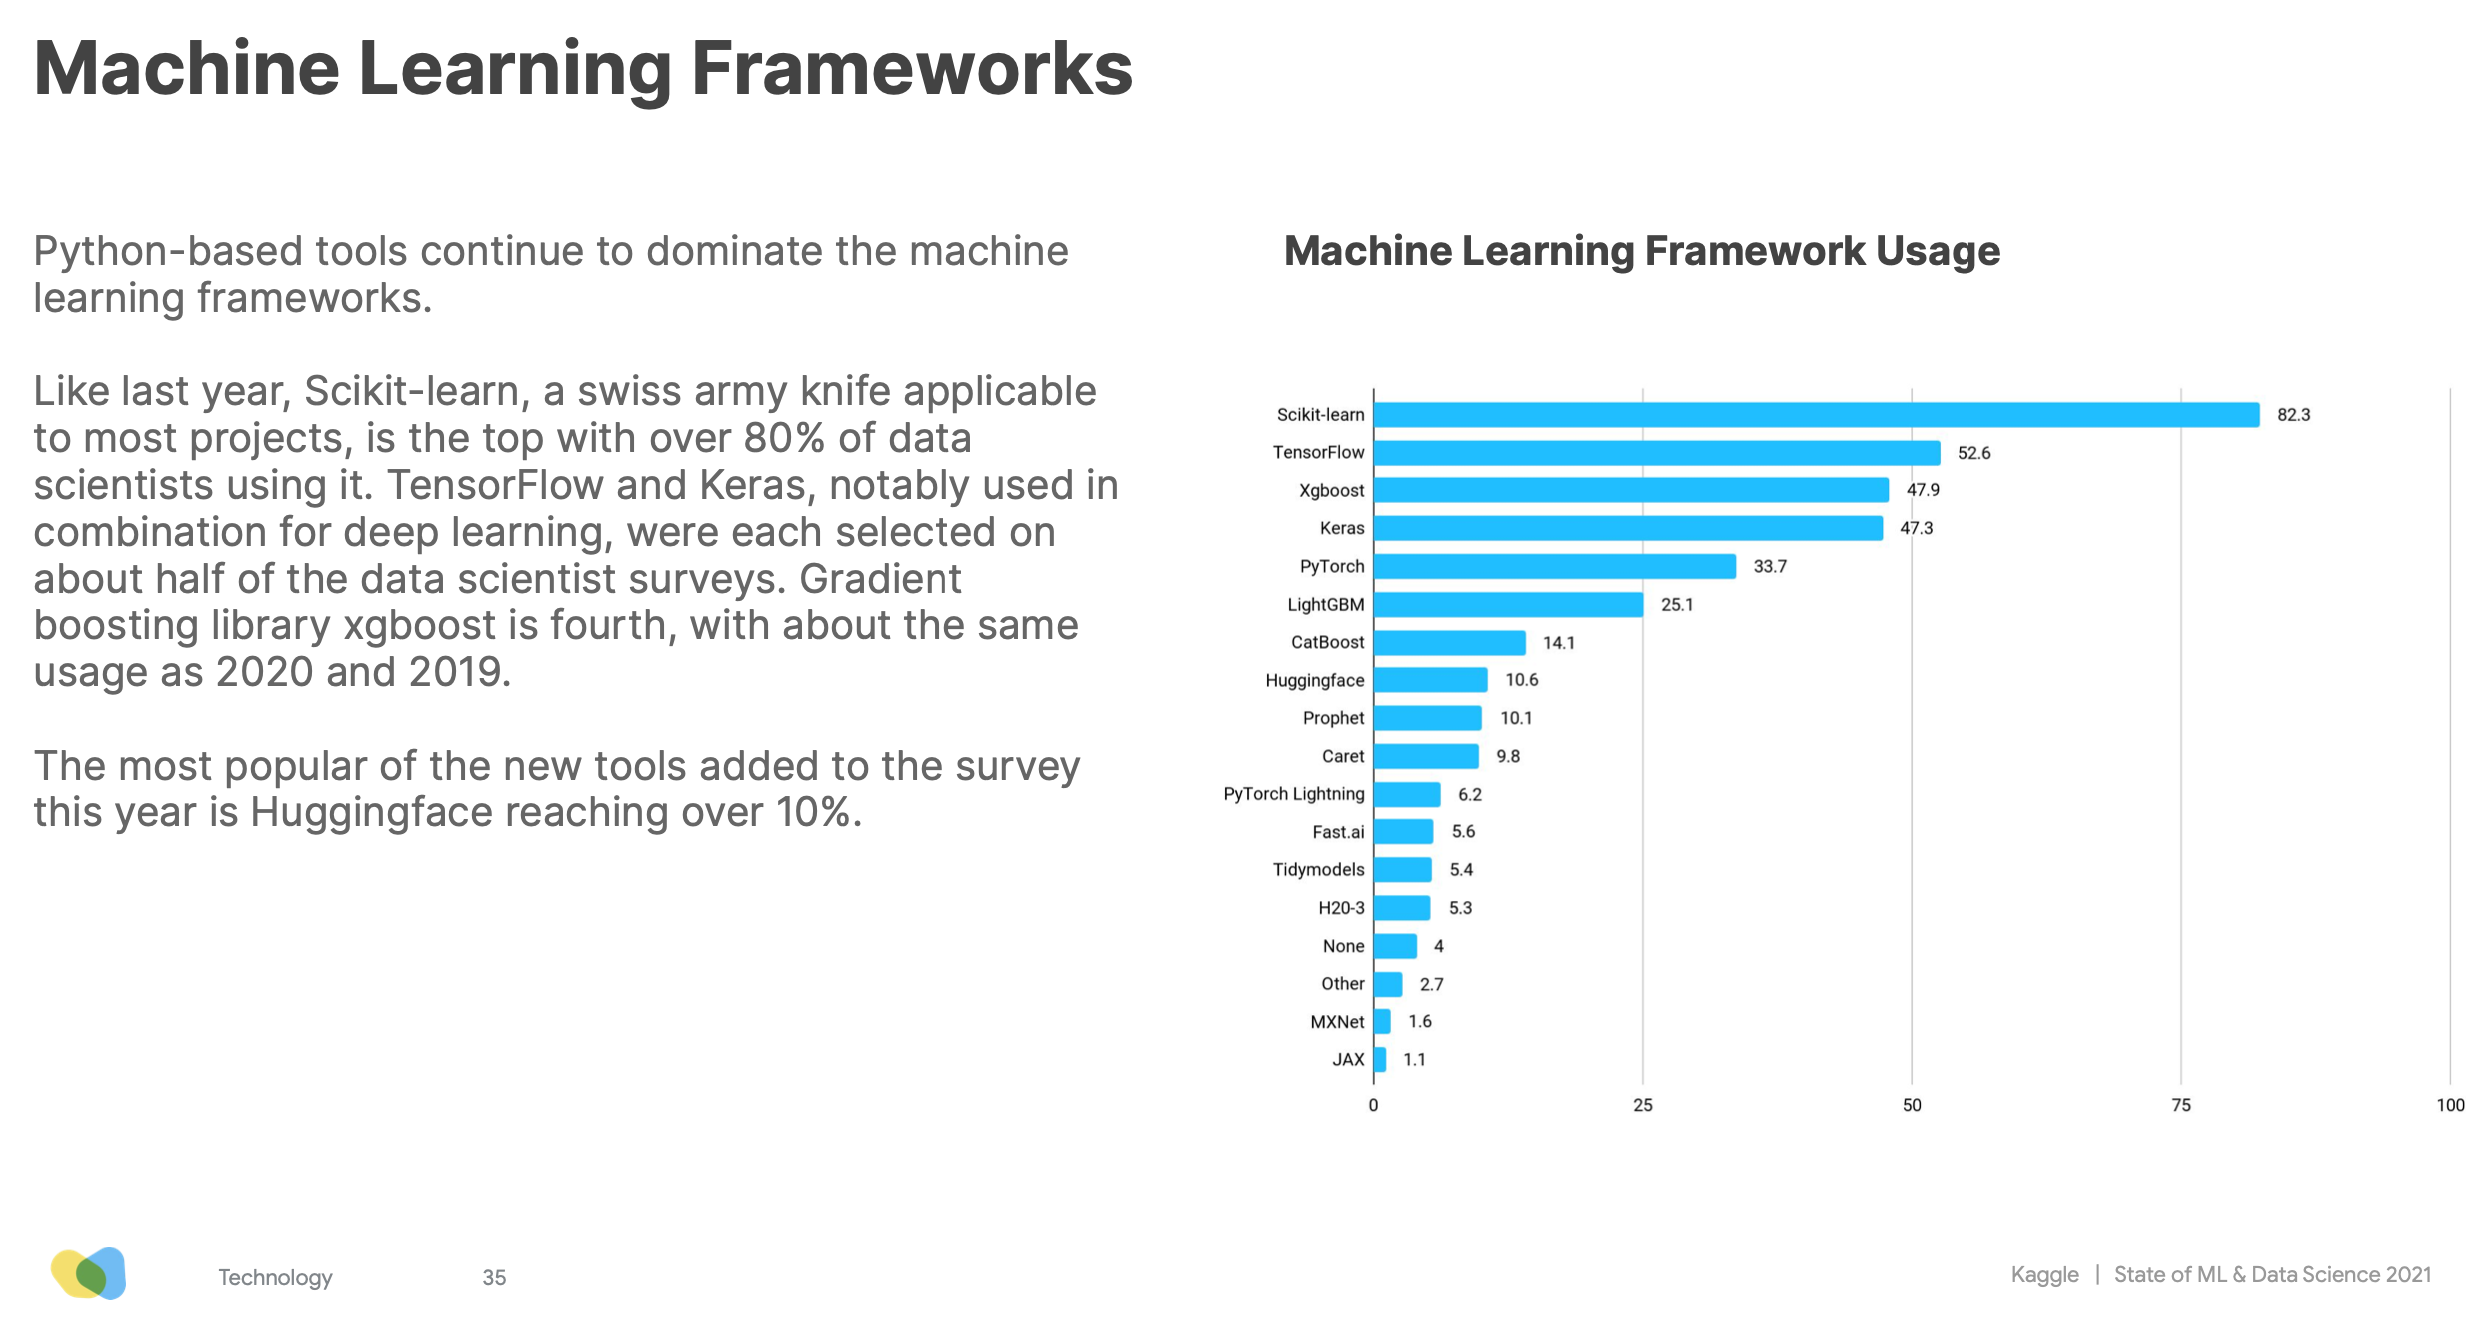
谢谢你们,我们才刚刚开始!
对 Hugging Face 如何帮助你的组织构建和部署生产级机器学习解决方案感兴趣?请通过 julsimon@huggingface.co 联系我 (招聘、推销勿扰)。
英文原文: https://hf.co/blog/the-age-of-ml-as-code
原文作者: Julien Simon
译者: Matrix Yao (姚伟峰),英特尔深度学习工程师,工作方向为 transformer-family 模型在各模态数据上的应用及大规模模型的训练推理。
审校/排版: zhongdongy (阿东)