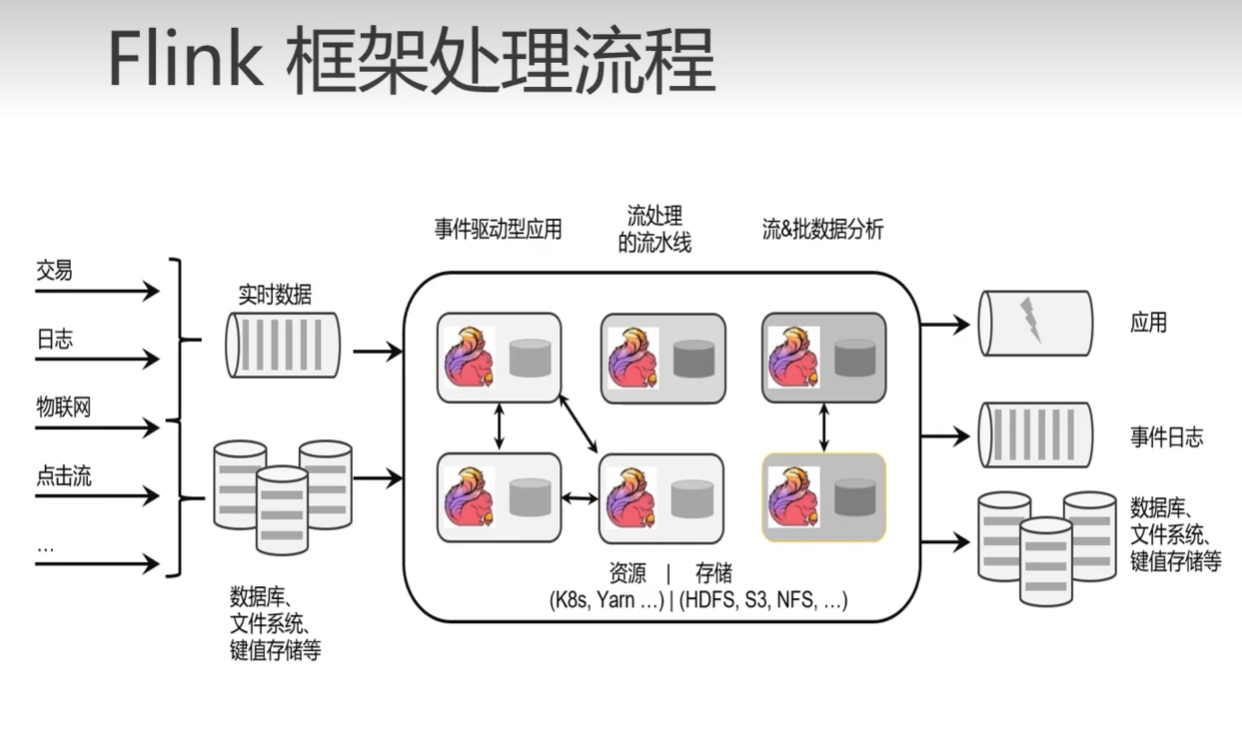
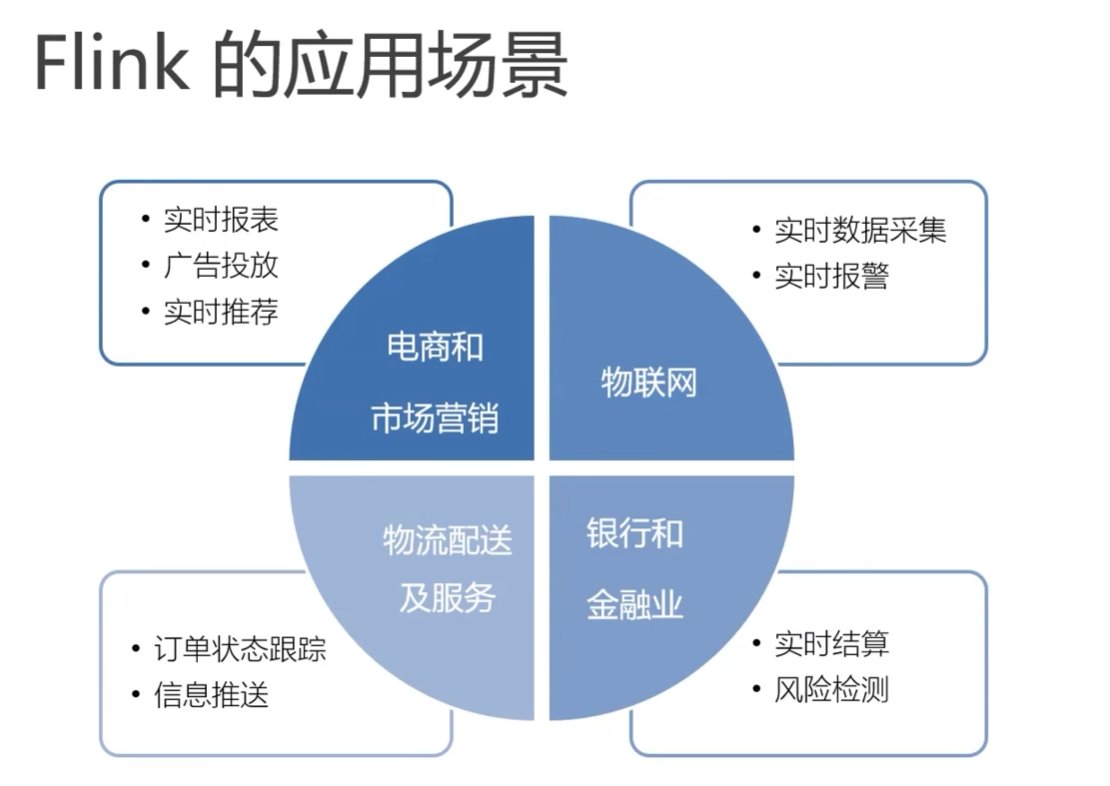
大数据-数据仓库-实时数仓架构分析

数据,数据仓库,实时,架构,分析 · 浏览次数 : 892

小编点评

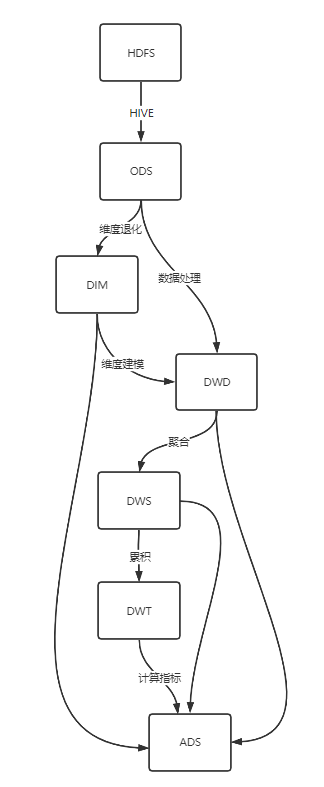
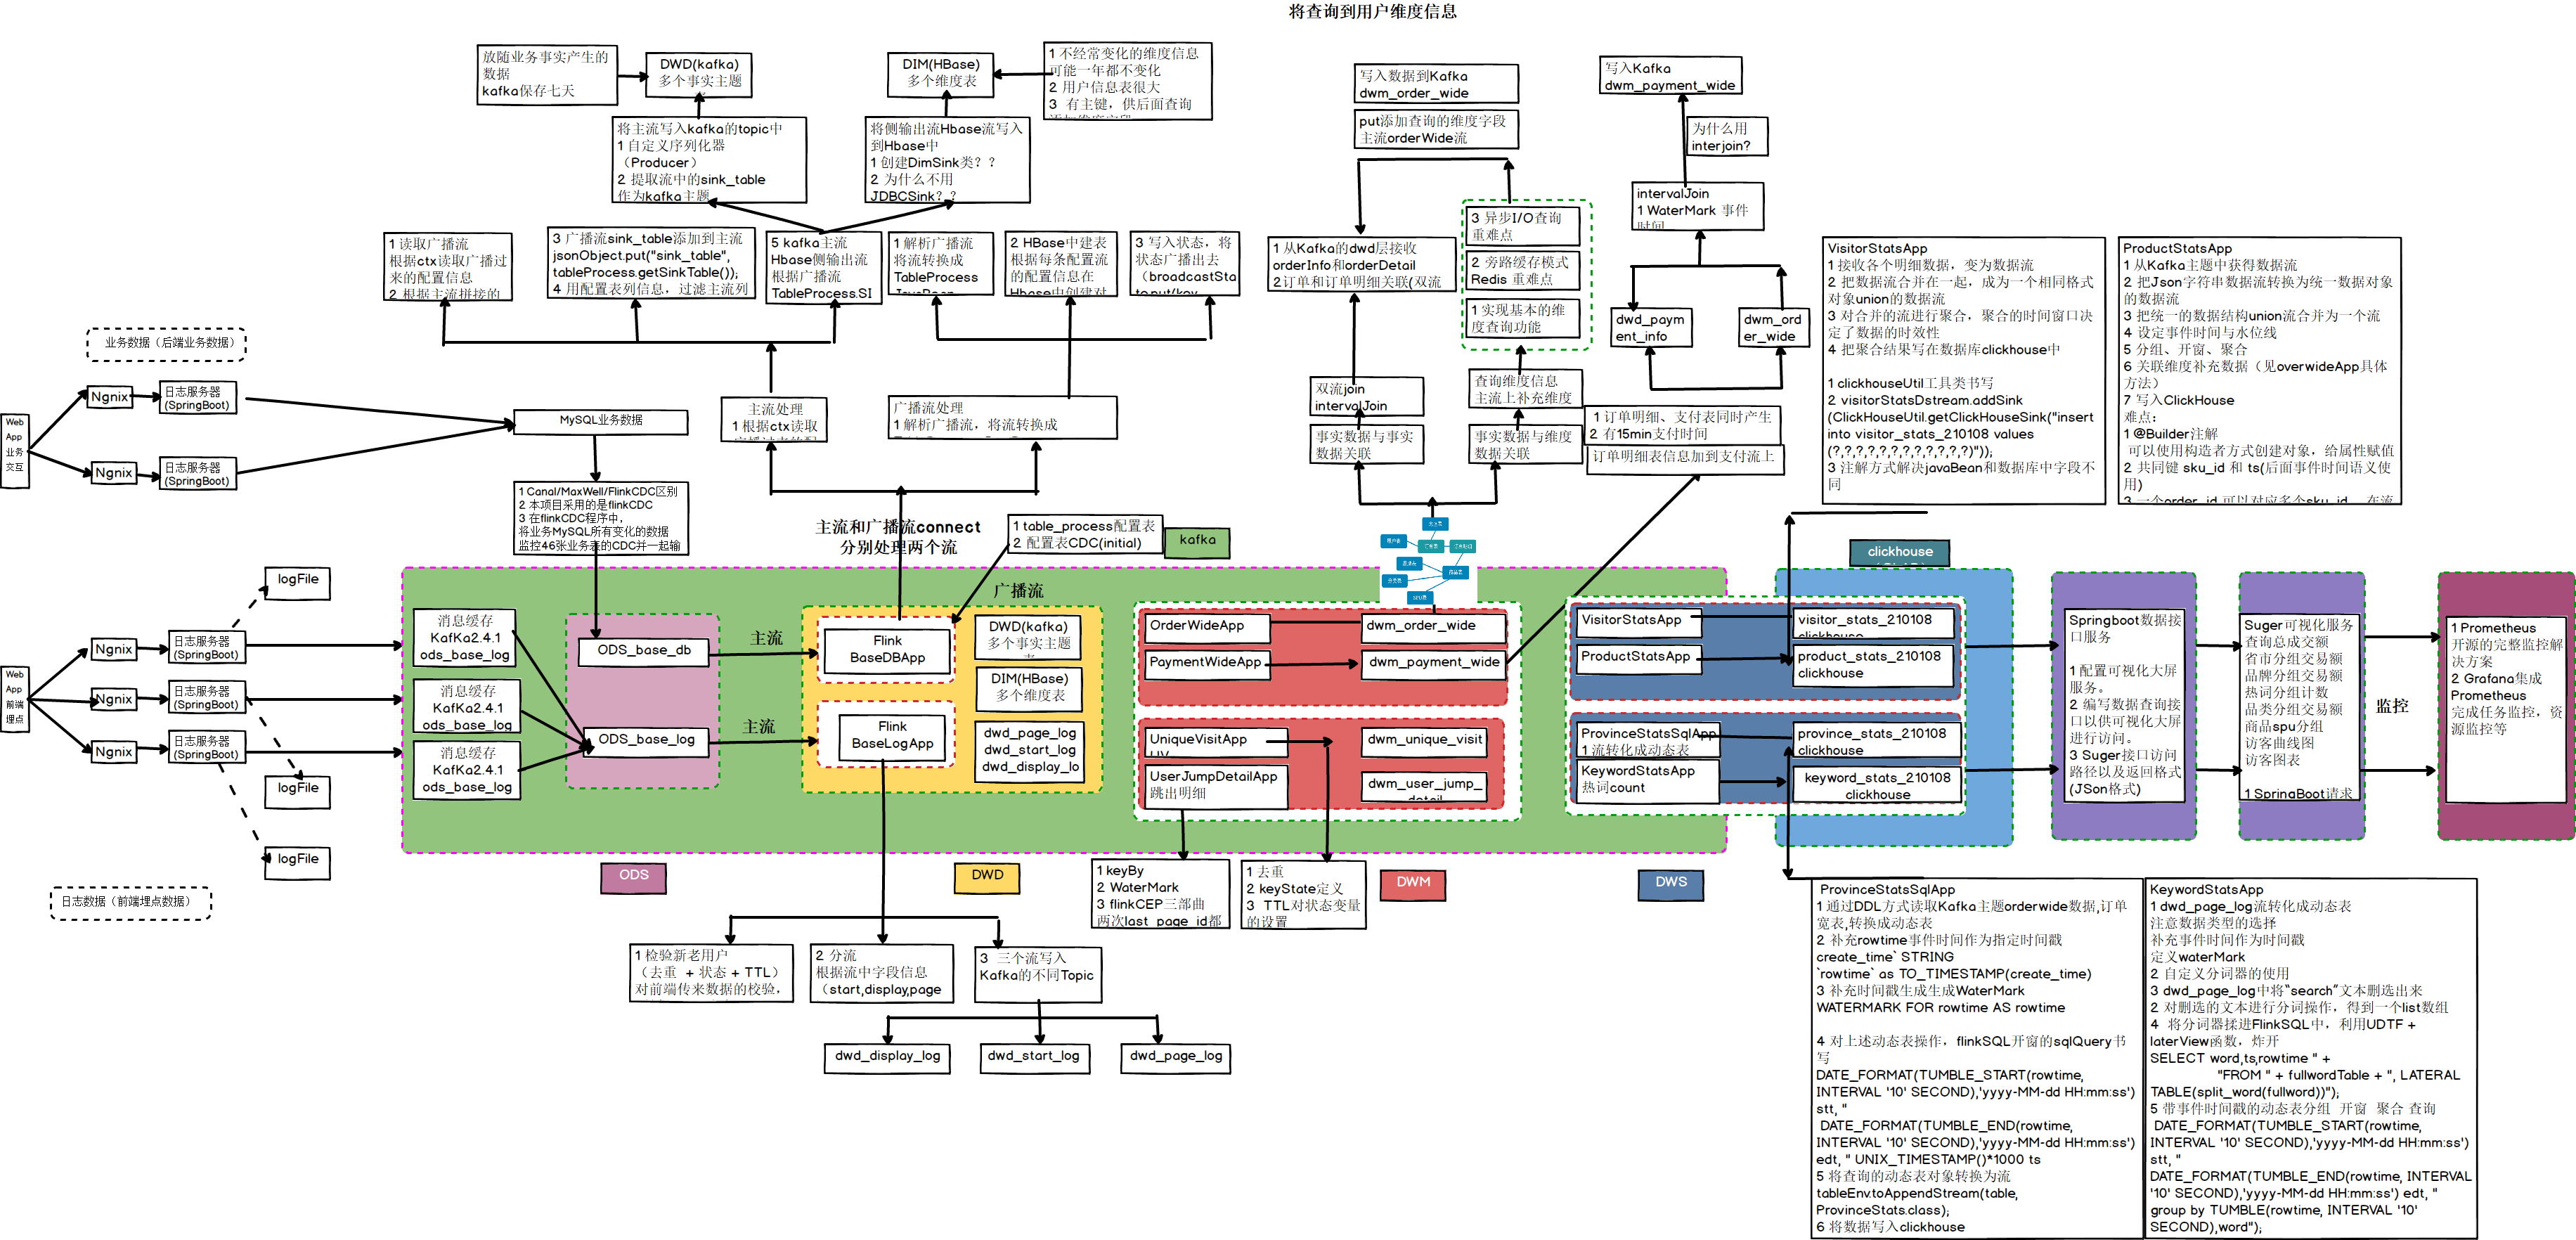
**数仓分层分层全称译名说明生成计算工具存储媒介压缩列式存储分区ODSOperation Data Store原始层原始数据FlinkCDCKafka✅✅✅DIMDimension维度层合并维度表FlinkHBase✅✅✅DWDData Warehouse Detail明细层数据处理、维度建模FlinkKafka✅✅✅DWMData Warehouse Middle中间层聚合FlinkKafka✅✅✅DWSData Warehouse Service层去主键聚合,得到原子指标FlinkClickhouse✅✅✅DWTData Warehouse Topic主题层存放主题对象的累积行为✅✅✅ADSApplication Data Store应用层具体业务指标Clickhouse可视化展示、用户画像、推荐系统、机器学习❌❌❌ODS:原始数据,行为日志数据和业务数据 放到 KafkaDIM:维度数据(业务数据-维度表)DWD:根据数据对象为单位进行分流,比如订单、页面访问等等(业务数据-事时数据、行为数据)DWM:对于部分数据对象进行进一步加工,比如独立访问、跳出行为,也可以和维度进行关联,形成宽表,依旧是明细数据。DWS:根据某个主题将多个事实数据轻度聚合,形成主题宽表。ADS:把ClickHouse中的数据根据可视化需进行筛选聚合命名规范库名:业务大类表名:分层名_业务细类临时表:temp_表名备份表:bak_表名视图:view_表名(场景:不共享的维度表、即席查询)

正文

image
image

数仓分层

分层 全称 译名 说明 生成计算工具 存储媒介 压缩 列式存储 分区
ODS Operation Data Store 原始层 原始数据 FlinkCDC Kafka ✅ ❌ ✅
DIM Dimension 维度层 合并维度表 Flink HBase ✅ ✅ ✅
DWD Data Warehouse Detail 明细层 数据处理、维度建模 Flink Kafka ✅ ✅ ✅
DWM Data Warehouse Middle 中间层 聚合 Flink Kafka ✅ ✅ ✅
DWS Data Warehouse Service 服务层 去主键聚合,得到原子指标 Flink Clickhouse ✅ ✅ ✅
DWT Data Warehouse Topic 主题层 存放主题对象的累积行为 ✅ ✅ ✅
ADS Application Data Store 应用层 具体业务指标 Clickhouse 可视化展示、用户画像、推荐系统、机器学习 ❌ ❌ ❌
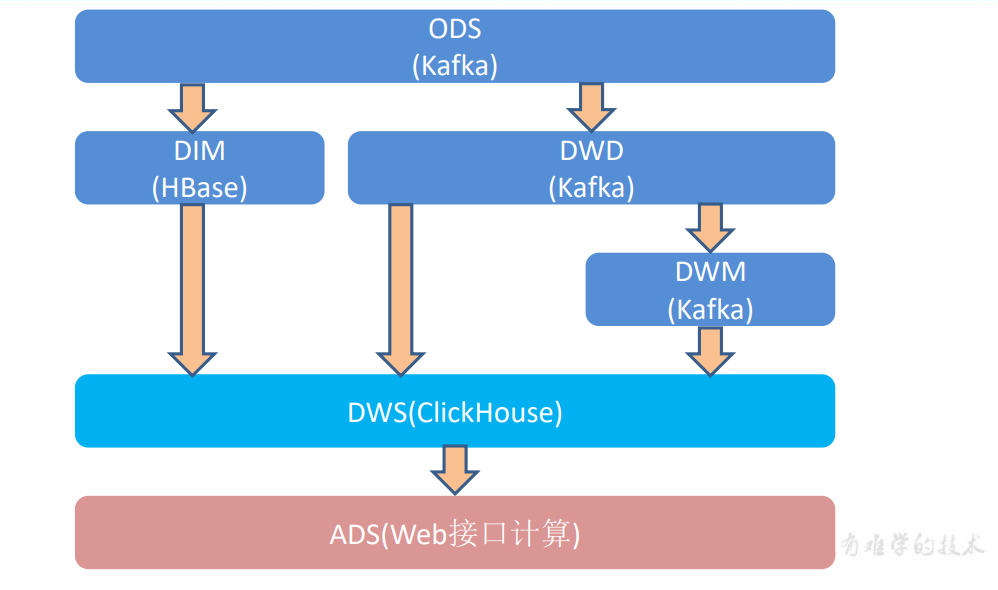
  • ODS:原始数据,行为日志数据和业务数据 放到 Kafka
  • DIM:维度数据(业务数据-维度表)
  • DWD:根据数据对象为单位进行分流,比如订单、页面访问等等(业务数据-事时数据、行为数据)
  • DWM:对于部分数据对象进行进一步加工,比如独立访问、跳出行为,也可以和维度进行关联,形成宽表,依旧是明细数据。
  • DWS:根据某个主题将多个事实数据轻度聚合,形成主题宽表。
  • ADS:把ClickHouse中的数据根据可视化需进行筛选聚合

image

命名规范

库名:业务大类
表名:分层名_业务细类
临时表:temp_表名
备份表:bak_表名
视图:view_表名(场景:不共享的维度表、即席查询)

分层 命名规范 说明 例
ODS ods+源类型+源表名+full/i full:全量同步
i:增量同步
ods_postgresql_sku_full
ods_mysql_order_detail_i
ods_frontend_log
DIM dim+维度+full/zip full:全量表
zip:拉链表
日期维度表没有后缀
dim_sku_full
dim_user_zip
dim_date
DWD dwd+事实+full/i full:全量事实
i:增量事实
DWS dws+原子指标 时间粒度有1d、1h…
1d:按1天
1h:按1小时
dws_page_visitor_1d
DWT dwt_消费者画像
ADS ads+衍生指标/派生指标

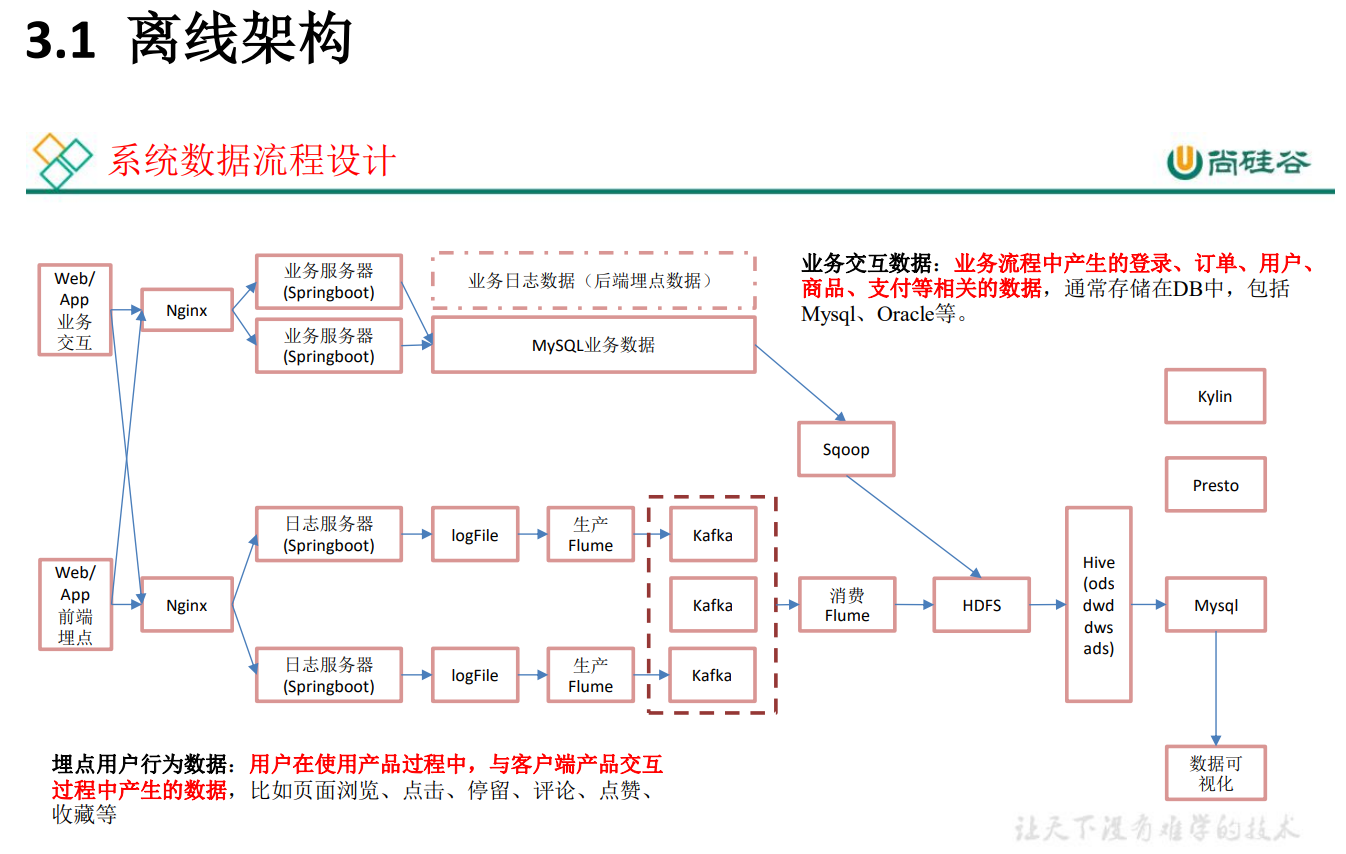
离线数仓:事实表,维度表,都放Hive
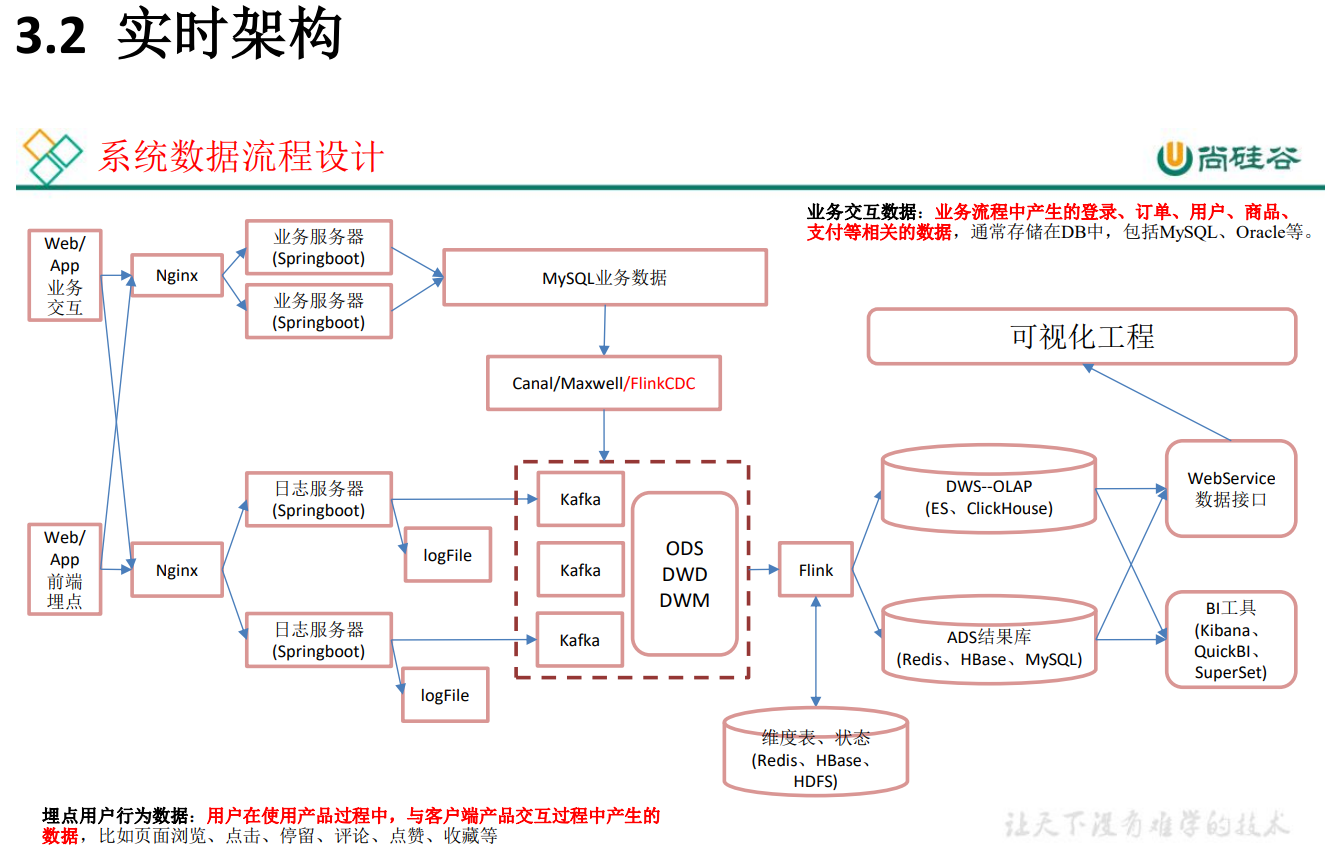
实时数仓:原始数据放 Kafka,维度数据 放 HBase,Phoenix

  • 离线计算:就是在计算开始前已知所有输入数据,输入数据不会产生变化,一般计算量级较大,计算时间也较长。例如今天早上一点,把昨天累积的日志,计算出所需结果。最经典的就是 Hadoop 的 MapReduce 方式;
    一般是根据前一日的数据生成报表,虽然统计指标、报表繁多,但是对时效性不敏感。从技术操作的角度,这部分属于批处理的操作。即根据确定范围的数据一次性计算。

  • 实时计算:输入数据是可以以序列化的方式一个个输入并进行处理的,也就是说在开始的时候并不需要知道所有的输入数据。与离线计算相比,运行时间短,计算量级相对较小。强调计算过程的时间要短,即所查当下给出结果。
    主要侧重于对当日数据的实时监控,通常业务逻辑相对离线需求简单一下,统计指标也少一些,但是更注重数据的时效性,以及用户的交互性。从技术操作的角度,这部分属于流处理的操作。根据数据源源不断地到达进行实时的运算。

  • 即席查询: 需求的临时性,小李,把两星期的数据拉给我看下(只在这个时刻需要)
    Presto: 当场计算(基于内存速度快)
    Kylin:预计算(提前算好),多维分析(Hive With Cube)

Sqoop 导入数据方式:

  • 增量: where 1=1、

  • 全量: where 创建时间=当天、

  • 新增及变化:where 创建时间=当天 or 操作时间=当天、

  • 特殊(只导入一次)
    Flume:

  • tailDirSource
    优点:断点续传,监控多目录多文件
    缺点:当文件更名之后,重新读取该文件造成数据重复
    注意:1. 要使用不更名的打印日志框架(logback)--一般logback 也会设置成更名的,每天一个日志文件,文件名带上日期,如果写死文件名,更名后可能会丢数据
    2.修改源码,让TailDirSource判断文件时,只看 iNode 值

  • KafkaChannel
    优点:将数据导入Kafka,省了一层Sink
    Kafka:生产者、消费者
    用法:1. Source-KafkaChannel-Sink
    2. Source-KafkaChannel
    3. KafkaChannel-Sink

逻辑线: 数据流、监控、优化、配置。

Kafka
  • Producer:ACK、拦截器、序列化器、分区器、发送流程、事务、幂等性,分区规则-->有指定分区发到指定分区,没有根据Key进行hash,都没有进行轮询(粘性)
  • Broker: Topic 副本-> 高可用 ISR LEO、HW ;分区:高并发、负载均衡(防止热点)
  • Consumer:分区分配规则 offset 保存(默认:_consumer_offsets 主题、其它:手动维护Offerset(MySQL)带事务,精准一次消费

image

分层的好处

  • 复杂问题拆解为多层
  • 减少重复开发(可以去中间层取数,不用每次都去原始层)
  • 隔离原始数据,例如:异常数据、敏感数据(用户电话…)

数据存储策略

  • 原始层保持数据原貌,不进行脱敏和清洗
  • 创建分区表(例如:日期分区),防止全表扫描
  • 数据压缩,减少磁盘占用(如:LZO、gzip、snappy)
  • 列式存储提高查询效率(如:Parquet、ORC)

离线架构:追求系统的稳定性、考虑到公司未来的发展,数据量一定会变得很大、早期的时间实时业务使用 SparkStreaming(微批次)

  • 优点:耦合性低、稳定性高
  • 缺点:时效性差

实时架构:Kafka集群高可用,数据量小,所有机器存在同一个机房,传输没有问题,
  • 优点:时效性好 Flink
  • 缺点:耦合性高,稳定性低

image
image
image

大数据-数据仓库-实时数仓架构分析
大数据-业务数据采集-FlinkCDC
大数据 - DWD&DIM 行为数据
大数据 - DWD&DIM 业务数据
大数据 DWM层 业务实现

与大数据-数据仓库-实时数仓架构分析相似的内容:

大数据-数据仓库-实时数仓架构分析

![image](https://img2023.cnblogs.com/blog/80824/202211/80824-20221128173125005-1682211493.png) ![image](https://img2023.cnblogs.com/blog/80824/202211/

大数据 - DWM层 业务实现

DWM 建表,需要看 DWS 需求。 DWS 来自维度(访客、商品、地区、关键词),为了出最终的指标 ADS 需求指标 DWT 为什么实时数仓没有DWT,因为它是历史的聚集,累积结果,实时数仓中不需要 DWD 不需要加工 DWM 需要加工的数据 统计主题 需求指标【ADS】输出方式计算来源来源层级

大数据 - DWS层 业务实现

统计主题 需求指标【ADS】输出方式计算来源来源层级 访客【DWS】pv可视化大屏page_log 直接可求dwd UV(DAU)可视化大屏需要用 page_log 过滤去重dwm UJ 跳出率可视化大屏需要通过 page_log 行为判断dwm 进入页面数可视化大屏需要识别开始访问标识dwd 连续

Bond——大数据时代的数据交换和存储格式

设想我们在一家很大的互联网公司做IT方面的规划、开发和维护,有以下这样的应用场景: 公司里有若干个不同的开发团队,开发语言有Java、.net、Python、C++....十来种,还有很多外包团队对项目进行开发,大中小系统已经多的数不过来;并且各个团队、系统间都需要进行海量数据的交换(比如搜索引擎实

现代数据平台要实现自助用数,要解决的三个问题

摘要:华为云FusionInsight MRS HetuEngine持续提升自助用数分析平台的可服务、易运维能力,基于AI技术持续提升对数据分析平台的智能化赋能水平,引领现代数据分析平台向专业化、智能化、易运维、高性能方向演进。 本文分享自华为云社区《现代数据平台要实现自助用数还要解决的三大问题》,

华为云GaussDB以技术创新引领金融行业分布式转型

摘要:分布式数据库以大集群规模、弹性伸缩等优异特性,满足了银行业务发展的多种需求,也因此成为各大银行关键基础设施技术创新建设的首选。 今天,由北京先进数通与华为联合主办的“银行业数字化转型实践交流会“第二站在成都顺利进行,各行业专家在现场一起交流了金融行业数字化转型的技术创新和实践成果。华为中国HC

大数据 - ClickHouse

https://clickhouse.com/ 概念 ClickHouse 是俄罗斯的 Yandex 于 2016 年开源的列式存储数据库(DBMS),使用 C++语言编写,主要用于在线分析处理查询(OLAP),能够使用 SQL 查询实时生成分析数据报告。 OLAP:一次写入,多次读取 ClickH

教你如何解决T+0的问题

摘要:T+0查询是指实时数据查询,数据查询统计时将涉及到最新产生的数据。 本文分享自华为云社区《大数据解决方案:解决T+0问题》,作者: 小虚竹 。 T+0问题 T+0查询是指实时数据查询,数据查询统计时将涉及到最新产生的数据。在数据量不大时,T+0很容易完成,直接基于生产数据库查询就可以了。但是,

HBase Meta 元信息表修复实践

HBase是一款开源高可靠、高可扩展性、高性能的分布式非关系型数据库,广泛应用于大数据处理、实时计算、数据存储和检索等领域。在分布式集群中,硬件故障是一种常态,硬件故障可能导致节点或者集群级别服务中断、meta表损坏、RIT、Region空洞、重叠等问题,如何快速修复故障恢复业务尤其重要,本文章主要...

大数据实时链路备战 —— 数据双流高保真压测

大数据时代,越来越多的业务依赖实时数据用于决策,比如促销调整,点击率预估、广告分佣等。为了保障业务的顺利开展,也为了保证整体大数据链路的高可用性,越来越多的0级系统建设双流,以保证日常及大促期间数据流的稳定性。